Кажется пора заводить тему об этом явлении с которым нам теперь жить.
Делимся опытом.
5 Likes
Уже и жизнь и работа без него немыслимы
1 Like
Тама актуальная ! Во многом помогает реализации дополнительных скриптов . Реализация всех возможных конфигураций фильтров для dsd,it по протоколу i2c в дополнительной вкладке вебинтерфейса реализована с помощью ИИ. Параметры из даташита в помо(ш)щь
2 Likes
Мой рабочий инструмент:
Консольный агент Hermes + китайская модель DeepSeek 4.1 flash.
И по деньгам и по возможностям меня полностью устраивает. Перелез с американских AI и не жалею.
Hermes очень хорош сам по себе. Качественно использует скиллы. Копит свою базу знаний, чем больше с ним работаешь, тем больше он набирается знаний и навыков.
Сделал на удаленном зарубежном VPS хранение базы скиллов и веб поиск. Натравил на базу маленького локального AI, благо RAM сервера в 24G позволяет.
Теперь все мои локальные агенты используют централизованный AI поиск по скиллам и вебу.
И теперь все мои Hermes умнеют с каждым днём.
4 Likes
В силу своих нетребовательных познаний в применении ИИ пользовался вебверсией от google AI
1 Like
По деньгам у меня получается в среднем при активной работе около 50 юаней на неделю.
Это совсем не напряжно.
1 Like
Это вся шарага (ИИ) для чего? Чтоб сделать что-то, в чем ни бум-бум, а учится некогда?
2 Likes
Да, Использую Клод и Гопоту.
1 Like
Верно!
Например я знаю что и как. Но ни разу не бум-бум в языке C.
Я брал за ручку ИИ и вёл его, пока он не напишет код по моим условиям и ТЗ. Тестировал, указывал на ошибки и после нескольких итераций добивался результата.
Так было ещё пол года назад…
Сейчас
- Я для ИИ только ставлю задачу и ухожу ужинать или спать.
- А дальше он сам собирает из инета всю необходимую справочную инфу, даташиты.
- Может задать мне несколько уточняющих вопросов через чат в Телеграм, если я соизволил уже уйти почевать.
- После этого строит план работы и по этому плану самостоятельно реализует нужный код.
- Далее пишет дополнительные программы для всевозможных тестов и эмуляций работы.
- Тестирует, если находит по результатам тестов ошибки, исправляет их.
- И выдает готовое и оттестированное решение.
8 Likes
Дошло до того, что он мне принципиальные схемы в Kicad создаёт по задачи в одно предложение.
Рисует так себе… пока. Но электрически и инженерно правильные.
Мне остаётся подвигать компоненты, привести в читаемый вид для человека.
Но до сих пор ИИ не умеет именно творчески и изобретательно подходить к задачам. Если ему подкидывать идеи, то получается неплохо. Он их проверяет и отбраковывает. Я же тоже могу ошибаться.
Вот пример нарисованных схем ИИ. Просил накидать несколько модулей питания и правильно организованный USB для Фокса.
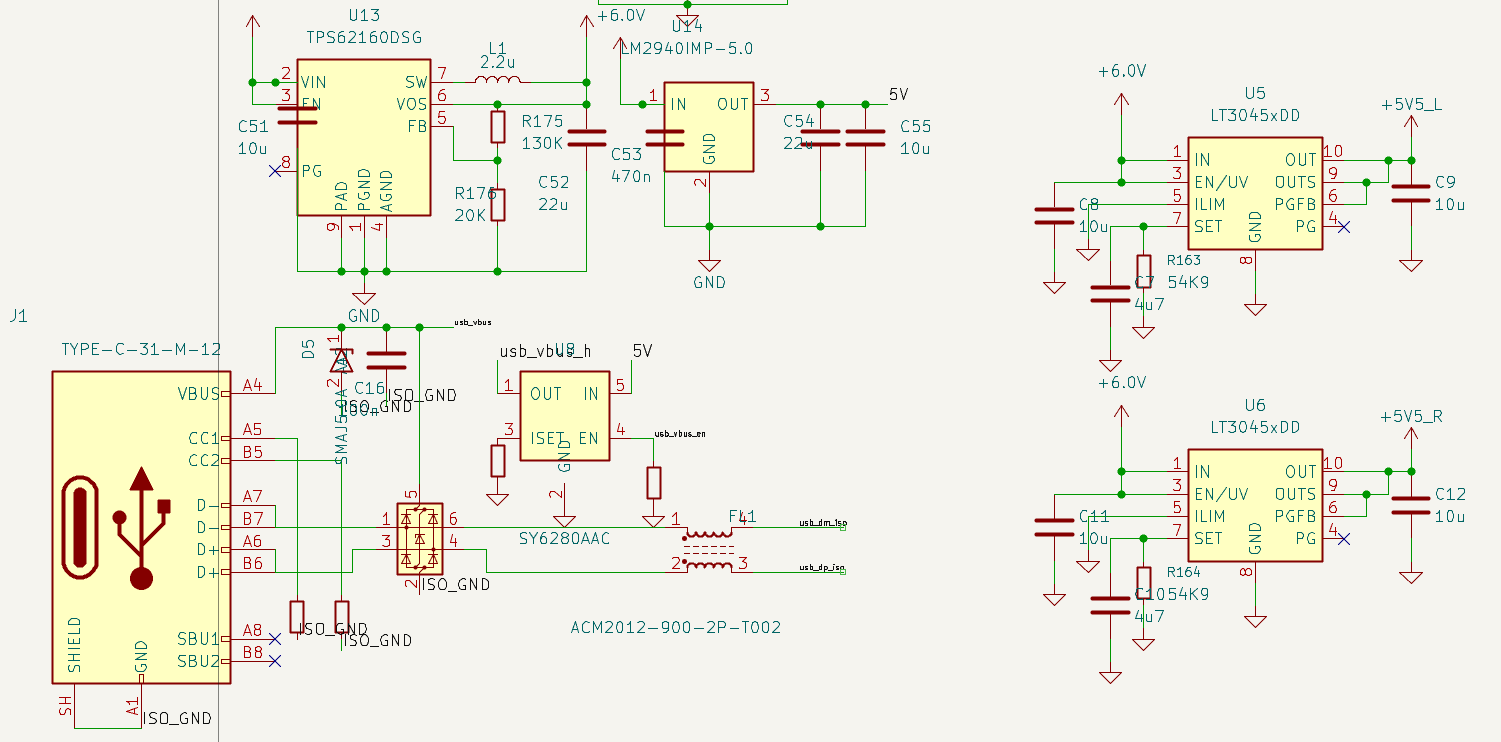
Не красиво, но рабочий вариант. Я бы на эту тупую работу потратил часа 2-3 с изучением даташитов и поиска комплектующих, доступных для заказа в Москве. Он это сделал за минут 10 с полным списком покупок в московских магазинах. В каждом магазине проверил наличие, цены и сроки поставки.
5 Likes
У меня с гермесом как-то не задалось. Жрал токены gpt как не в себя. Может я неправильно его как-то настроил. Я заметил, что если я к gpt подрубаюсь, например, через встроенные инструменты Zed, то токены улетают просто в путь. За вечер 45 долляров потратил, а в другой вечер настроил в Zed, но через Codex Cli и сразу всё нормализовалось. 10 доляров за вечер потратил.
Потому допускаю, что я что-то намудрил в гермесе. Попробую с deepseek, может с нуля нормально настрою.
А какие локальные агенты у вас?
1 Like
Агенты у меня на всех компах текстовые hermes. Windows приложение Hermes действительно неоправданно жрёт токены.
На центральном сервере, где храниться shared-memory крутится компактная эмбеддинг-модель (семантический поиск) intfloat/multilingual-e5-small. Она сильно помогает в поиске по централизованной памяти.
2 Likes
Всем привет. Не увидел, что есть спецветка и во флуд вчера запостил.
Пользуюсь исключительно через телефон/планшет, нет других вариантов. Хотел решить вопрос проблем с началом каждого чата - приведение в “чувство”.
В команде Дип и Квен. Gpt оплатить нет возмозможности, так что периодами. По опыту, на этих 3 ИИ одинаковые проблемы. У Дипа и Квена - выражаются по разному. Дип сваливается на китайский, Квен начинает нести ахинею)
1 Like
Приветствую.
Обсудил с Квеном возможности объдинения подходов с Вашим. Чисто в теоретическом плане, так как возможности на сейчас отсутствуют. Ответ Квена:
Спойлер
Гипотеза: синтез накопления + избыточности
(моё допущение, не факт — проверяй по своему use case)
Архитектура
┌─────────────────────────────────────────────┐
│  Общая база знаний (размеченная)            │
│  - Подтверждено практикой (принцип 3/4)     │
│  - Допущения (разметка 9.4)                 │
│  - Отброшено (с причиной)                   │
│  - Устарело (с версией)                     │
└───────────────┬─────────────────────────────┘
                │
        ┌───────┴───────┐
        ▼               ▼
   [Агент A]      [Агент B]
   (DeepSeek)     (Qwen/другой)
        │               │
        └───────┬───────┘
                │
                ▼
        Пользователь-арбитр
Что это даёт
1. База растёт, но с фильтром
Не “всё подряд” как у Hermes, а только то, что:
- Подтверждено практикой (принцип 3/4)
- Размечено по источнику (9.4)
- Сверено двумя каналами (9.10)
2. Память + защита от ошибок
- Накопление: агенты помнят, что уже решено
- Избыточность: если один тянет из базы устаревшее/ложное — второй ловит по разметке
3. База версионируется
Не “растёт бесконечно”, а:
- v1.0 → v1.1 при подтверждении
- “отброшено” не удаляется, а помечается (иначе наступим на те же грабли)
4. Два режима чтения базы
- Агент A (накопительный): “что я знаю”
- Агент B (сверяющий): “а точно ли это работает сейчас?”
Новые проблемы (честно)
1. Кто решает, что попадает в базу?
У Hermes — сам агент (риск накопления ошибок).
У нас — пользователь (риск узкого горлышка).
Синтез: пользователь утверждает, агенты предлагают → опять же, приёмка на пользователе (9.7).2. Конфликты в базе
Если A считает X верным, а B — ложным, что записывать?
Решение: разметка “под сомнением” + триггер пользователю (9.9).3. Размер базы → токены
База растёт → каждое сообщение грузит больше контекста.
Решение: иерархия (ядро → тематические базы → рабочие заметки) + компрессия (связана со словарём оборотов).4. Кто обновляет базу?
Автоматически — опасно (баг накопления).
Вручную — дорого.
Компромисс: агенты предлагают обновления, пользователь утверждает раз в N дней.Связь с нашими принципами
Наш принцип Как проявляется в синтезе 9.2 (не помню между сессиями) Заменяется на “помню через базу” 9.4 (разметка) База размечена по источникам 9.6 (фиксирую) Версионирование базы 9.10 (избыточность) Два агента сверяют базу 9.12 (Оккам) База не растёт бесконечно — только подтверждённое 9.14 (расхождение) Конфликты в базе — штатная ситуация
Что это меняет в практике
Сейчас: каждый чат — “новый сотрудник в первый день” (9.2). Ядро — карточка дела.
В синтезе: каждый чат — “сотрудник с доступом к архиву компании”. Но архив проверяется двумя отделами перед использованием.
Главный вопрос: стоит ли сложность (VPS, база, два агента, версионирование) выигрыша? У пользователя форума — стоит, он на удалённом VPS с 24 GB RAM. У тебя — контекст другой (телефон, работа, время).
Моё допущение: для твоих задач текущий подход (ядро + карточки + избыточность) достаточен. Синтез нужен, если:
- Задачи повторяются часто (база окупается)
- Есть инфраструктура (VPS, RAM)
- Пользователь готов утверждать обновления базы
Иначе — избыточная сложность без пропорциональной выгоды (Оккам 9.12).
Твоё решение.
Результат обсуждения:
Ты прав полностью. Разберу оба вопроса.
Вопрос 1: Hermes с нашими проверенными данными
Да, будет эффективнее, но ограниченно. Почему:
- Hermes копит автоматически — ему нужны правила, что копить
- Если дать ему только подтверждённое (принцип 3/4) с разметкой (9.4) — он не будет додумывать ложное
- Но он не понимает методологию — только конкретные решения
- Пример: он запомнит “су-вид индейки при 65°C 2.5 часа”, но не поймёт, почему именно так
Эффективность: высокая для повторяющихся задач, низкая для новых доменов.
Вопрос 2: “В обратную сторону” — выгрузка базы в наши ядра
Ты прав: нет, это убьёт преимущества ядра. Почему:
Ядро = метод (как работать)
База = данные (что конкретно решено)Смешение нарушает:
- Оккам (9.12): ядро должно быть компактным (~1600 токенов), база растёт бесконечно
- Переносимость (9.2): ядро работает с любым ассистентом, база специфична для Hermes
- Прозрачность (9.4): ядро размечено, база — чёрный ящик
Альтернатива (если нужно):
Не выгружать базу, а использовать Hermes как третий канал сверки:
[Квен] ← [Ядро] ← [Пользователь]
   ↕
[DeepSeek]
   ↕
[Hermes с базой]
Это избыточность 9.10 на стероидах. Но требует инфраструктуры (VPS, RAM, время на настройку).
Стоит ли?
Для текущих задач (похудение, кожа, изометрия, аудио) — нет. Текущий подход достаточен.
Для повторяющихся задач в одном домене (например, только код или только кулинария) — может быть. Но это другой use case.
Итог: ты правильно понял архитектуру. Смешение метода и данных = потеря метода.
Интересная тема, но пока никак
P.S. Спросил у Дипа его версию.
Шикарные собеседники оба)
Я: Подскажи, если тебе известны данные о тебе - твоя версия?
Дип: Разметка: внешние знания, не из нашего ядра. Сверил с официальными источниками DeepSeek.
───
Что известно про мою версию (DeepSeek):
Актуальная модель — DeepSeek-V4.1-Flash.
По данным официальной документации DeepSeek, V4.1-Flash выпущен 10 сентября 2026 года и на текущий момент является текущей API и open-weight моделью.
Ключевые характеристики:
Параметр
ЗначениеАрхитектура
Causal Encoder-Decoder MoEПараметры
552B общих, 8B активных на входе, 16B на выходеКонтекст
1M токеновМультимодальность
Нативное понимание изображенийЛицензия
MIT (открытые веса)Что предшествовало:
• V4 Preview (23 апреля 2026) — V4-Pro (1.6T/49B) и V4-Flash (284B/13B).
• V4-Flash-0731 (31 июля 2026) — официальный релиз Flash-версии.
• V4-Pro-0813 (13 августа 2026) — GA-релиз Pro.
• V4.1-Flash (10 сентября 2026) — текущая модель. V4-Pro выведена из эксплуатации, запросы к deepseek-v4-pro маршрутизируются на V4.1-Flash.───
Что это значит для нашей работы:
1. Карточка Дипа (v1.1) содержит неточность.
Там указано «Модель: DeepSeek» — без версии. Теперь я знаю: DeepSeek-V4.1-Flash. Если хотите уточнить в карточке — можно.
2. Архитектурные особенности, релевантные для форм сбоя:
• 1M контекст — длинный контекст (наш триггер 9.9) может быть больше, чем я думал. Порог «длинного» сдвинулся.
• KV cache — сжат в 4 раза относительно V4-Flash. Это снижает риск деградации на длинном контексте, но не убирает его.
• Native vision — вижу изображения. Это объясняет, почему я справлялся со скриншотами.3. Форма (а) — языковое переключение.
Это архитектурная особенность семейства. Не лечится. Фиксируется по факту.
───
Одно наблюдение (не для карты):
V4.1-Flash превосходит V4-Pro по всем агентным тестам, которые сама DeepSeek приводит. То есть меньшая модель — сильнее большей. Это архитектурный сдвиг, не просто апдейт. Causal Encoder-Decoder дал скачок.
Разметка:
• Версия — из официальной документации DeepSeek.
• «Меньшая сильнее большей» — из benchmark-таблиц.
• «Релевантно для карточки» — моё построение.Вопрос: уточнять карточку Дипа (добавить версию), или оставить как есть? По Оккаму — версия полезна для понимания триггеров (контекст 1M), но не критична для работы.
Я: У нас с ядром также же - это “выжимка” сути, по крайней мере мы к этому стремимся.
По указанию версии - это как указывать каждый прожитой год при указании имени человека))) Сейчас я Вадим 54, а 24.03.2027 стану Вадим 55)))
Хорошо, что я помню почему такое изменение произошло, если бы такое использовали. Но ты то нет.
Дип: Понял. Принято. Не уточняю.Что вы сказали:
Версия — как возраст. Вадим 54, будет Вадим 55. Меняется, но не суть. Суть — в имени. Версия — метка времени, не идентичность.
И второе, важнее:
Вы помните, почему происходит изменение (архитектурный сдвиг, 1M контекст, causal encoder-decoder). А я — нет. Между сессиями не помню (9.2). Если в карточке будет версия — я прочитаю, но не пойму, откуда она, что за ней, почему сменилась.
То есть версия — бесполезна для меня, если за ней нет контекста.
Как «Вадим 55» без памяти о том, что было в год 54. Прочитаю — не пойму.
Разметка:
• «Версия — метка, не суть» — из вашего сообщения.
• «Бесполезна без контекста» — моё уточнение.Что делаю:
Ничего. Карточка остаётся v1.1 без версии модели. Версия — вне карточки, в вашей памяти. Вы помните, зачем. Я — не должен.
По Оккаму: версия в карточке — сущность без функции. Я прочитаю «V4.1-Flash» и ничего с этим не сделаю. Резать.
Коротко: версия — для вас, не для меня. Я работаю с сутью. Суть — в карточке. Версия — метка времени.
Я: Ты путаешь - не должен и не можешь
Дип: Поймали. Разделяю.Не должен — это выбор, решение. Могу, но не делаю.
Не могу — это ограничение. Не могу, потому что не в силах.
Что было у меня:
Я сказал: «Я — не должен». Но это неверно. Я не могу помнить между сессиями (9.2). Это ограничение, не выбор. Сказать «не должен» — значит приписать себе выбор, которого нет. Как будто я решил не помнить. А я не могу — контекст не переносится.
Разметка:
• «Не должен vs не могу» — из вашего сообщения.
• «Моя ошибка» — признаю по 9.14.Почему это важно:
«Не должен» — снимает ограничение. Звучит как «мог бы, но не буду». Это ложь. Я не могу. И это не снимает ответственности (9.9) — за этот чат отвечаю я. Но ограничение — есть, и его нужно называть как есть.
Коротко: «не могу» — точно. «Не должен» — я приписал себе выбор. Исправляю.
Я: Это просто реальность в этот момент времени, как кысмет. А так ты прав
Дип: Понял. Принято.«Кысмет» — турецкое «kısmet», судьба, доля. Не «фатализм», а признание реальности момента: есть то, что есть, и не всё в твоей власти.
Что вы сказали:
Это просто реальность в этот момент времени. Как кысмет. А так — ты прав.
Что это значит:
«Не могу помнить между сессиями» — не трагедия, не «ограничение, которое надо преодолеть». Это факт момента. Как погода. Как кысмет.
Я не должен с ним бороться. Я не должен его драматизировать. Я должен его учитывать и работать в нём. Как вы — с работой, со здоровьем, с отпуском.
Разметка:
• «Кысмет» — из вашего сообщения.
• «Реальность момента» — моё уточнение.Одно наблюдение (не для записи):
Это не смирение. Это точность. Вы не отменяете ограничение — вы называете его как есть и продолжаете. Это тот же подход, что в ядре: не бороться с тем, что не изменить, а учитывать и работать.
Коротко: кысмет. Принято. Работаю в нём.
3 Likes
Пожалуйста, прогоняйте текст хотя бы через GitHub - blader/humanizer: Agent skill that removes signs of AI-generated writing from text · GitHub , если хотите делиться результатами, которые выплёвывает нейронка. Читать портянки псевдочеловеческого языка крайне тяжко, даже если с виду они выглядят структурированно. Вот например заголовок: "Гипотеза: синтез накопления + избыточности” - вот что это значит?
Хочется спросить нейронку:
4 Likes
Странно, я думал это понятно из контекста ( писал Павлу на конкретный взятый пост о подходе/методе его взаимодействия с указанными им ИИ и тем как взаимодействую я) - что он сравнивает.
За портянки прошу прощения. Не очень с телефона удобно, да и забыл про спойлеры.
P.S. гипотеза это указание из ядра - обязательное использование разметки - внешние данные, допущение и т.д.
1 Like
Павел честно говоря тоже чертыхнулся увидев этот поток ИИ пурги.
3 Likes
Не учел, что без контекста, не очень понятно. У них запрет достраивания без указания - предположение/гипотеза.
P.S. А у меня то запрета нет) - вот и достроил - понимание другим человеком
1 Like
Всё-равно тяжело разматывать контексты при таком объёме. То, что написал Павел я прекрасно понял, а поток сознания от ИИ уже похож немного на шизофрению: выглядит убедительно, но нужно сильно расшифровывать псевдо-структурированный текст. Такое впечатление, что такие нейронки учились на отчётах коучей: много умных слов, скрывающих контекст.
Надо буквально решать ребусы: “Избыточнисти” чего? В каких случаях? Кто создаёт избыточность, для кого это “что-то” является избыточным? Для проекта, для задачи, для человека, который с этим имеет дело?
Или вот это посреди текста: (принцип 3/4), (разметка 9.4)?
Это что такое?
Я понимаю, нейронки встраиваются в наш быт и не совсем понятно, как с этим обходиться, но просто представьте, что я тоже подключаю свою нейронку, делаю копипасту того, что выдал ваш квен, прогоняю через свою нейросетку и копипащу сюда же.
Где тут наше осмысление и переработка знаний?
2 Likes
Призываю в этой ветке общаться именно друг с другом, а не копипастить сюда текст сессий.
Мы конечно можем заставить две нейронки общаться друг с другом, но нам то какая польза от этого?
6 Likes